
昨天把框架拿掉,用八十行原生 Python 跑通了整個 Agent Loop,也算出了自架與商業 API 的損益平衡點。
那件事帶來一個後續的問題:既然 Agent Loop 本身這麼薄,那什麼時候真的需要它?
這不是抽象的架構討論。在實務上,過去兩年出現了一種相當明顯的傾向:把所有軟體邏輯都改寫成自主 Agent。 表單驗證想交給 Agent、固定的欄位轉換想交給 Agent、連合規要求極高的轉帳流程都想交給 Agent 動態決策。
結果多半是三件事同時發生:延遲從毫秒變成數秒、Token 成本居高不下,以及偶發性地出現沒人預期過的執行路徑。
而那些工作,本來一個 for 迴圈加幾個 if 就解決了。
以下的內容,會先把 Flow 與 Agent 的本質差異講清楚,接著給出一組四個判準的決策矩陣,然後說明「Flow 包裹 Agent」這個混合架構的三種常見形態,最後是幾個值得記住的反模式。
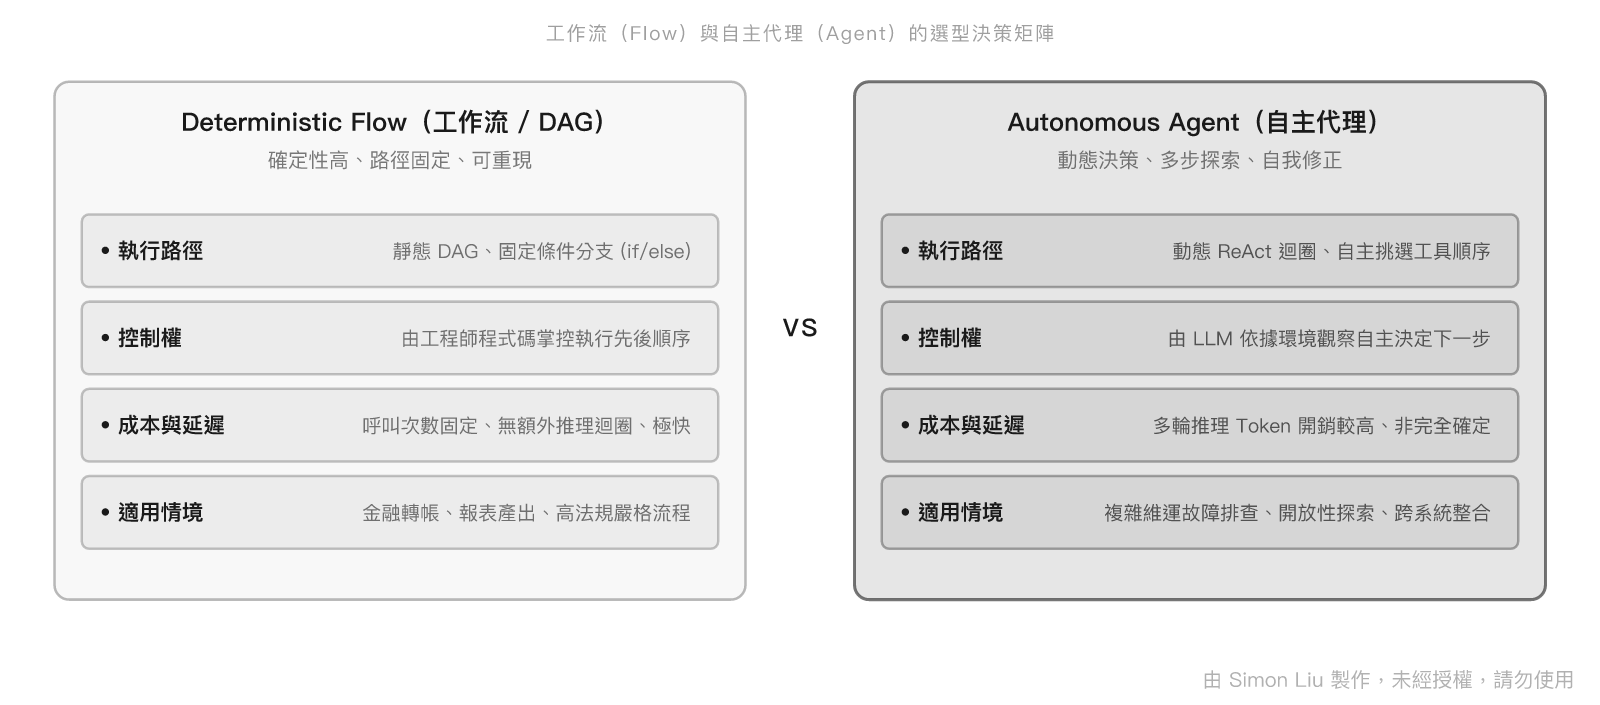
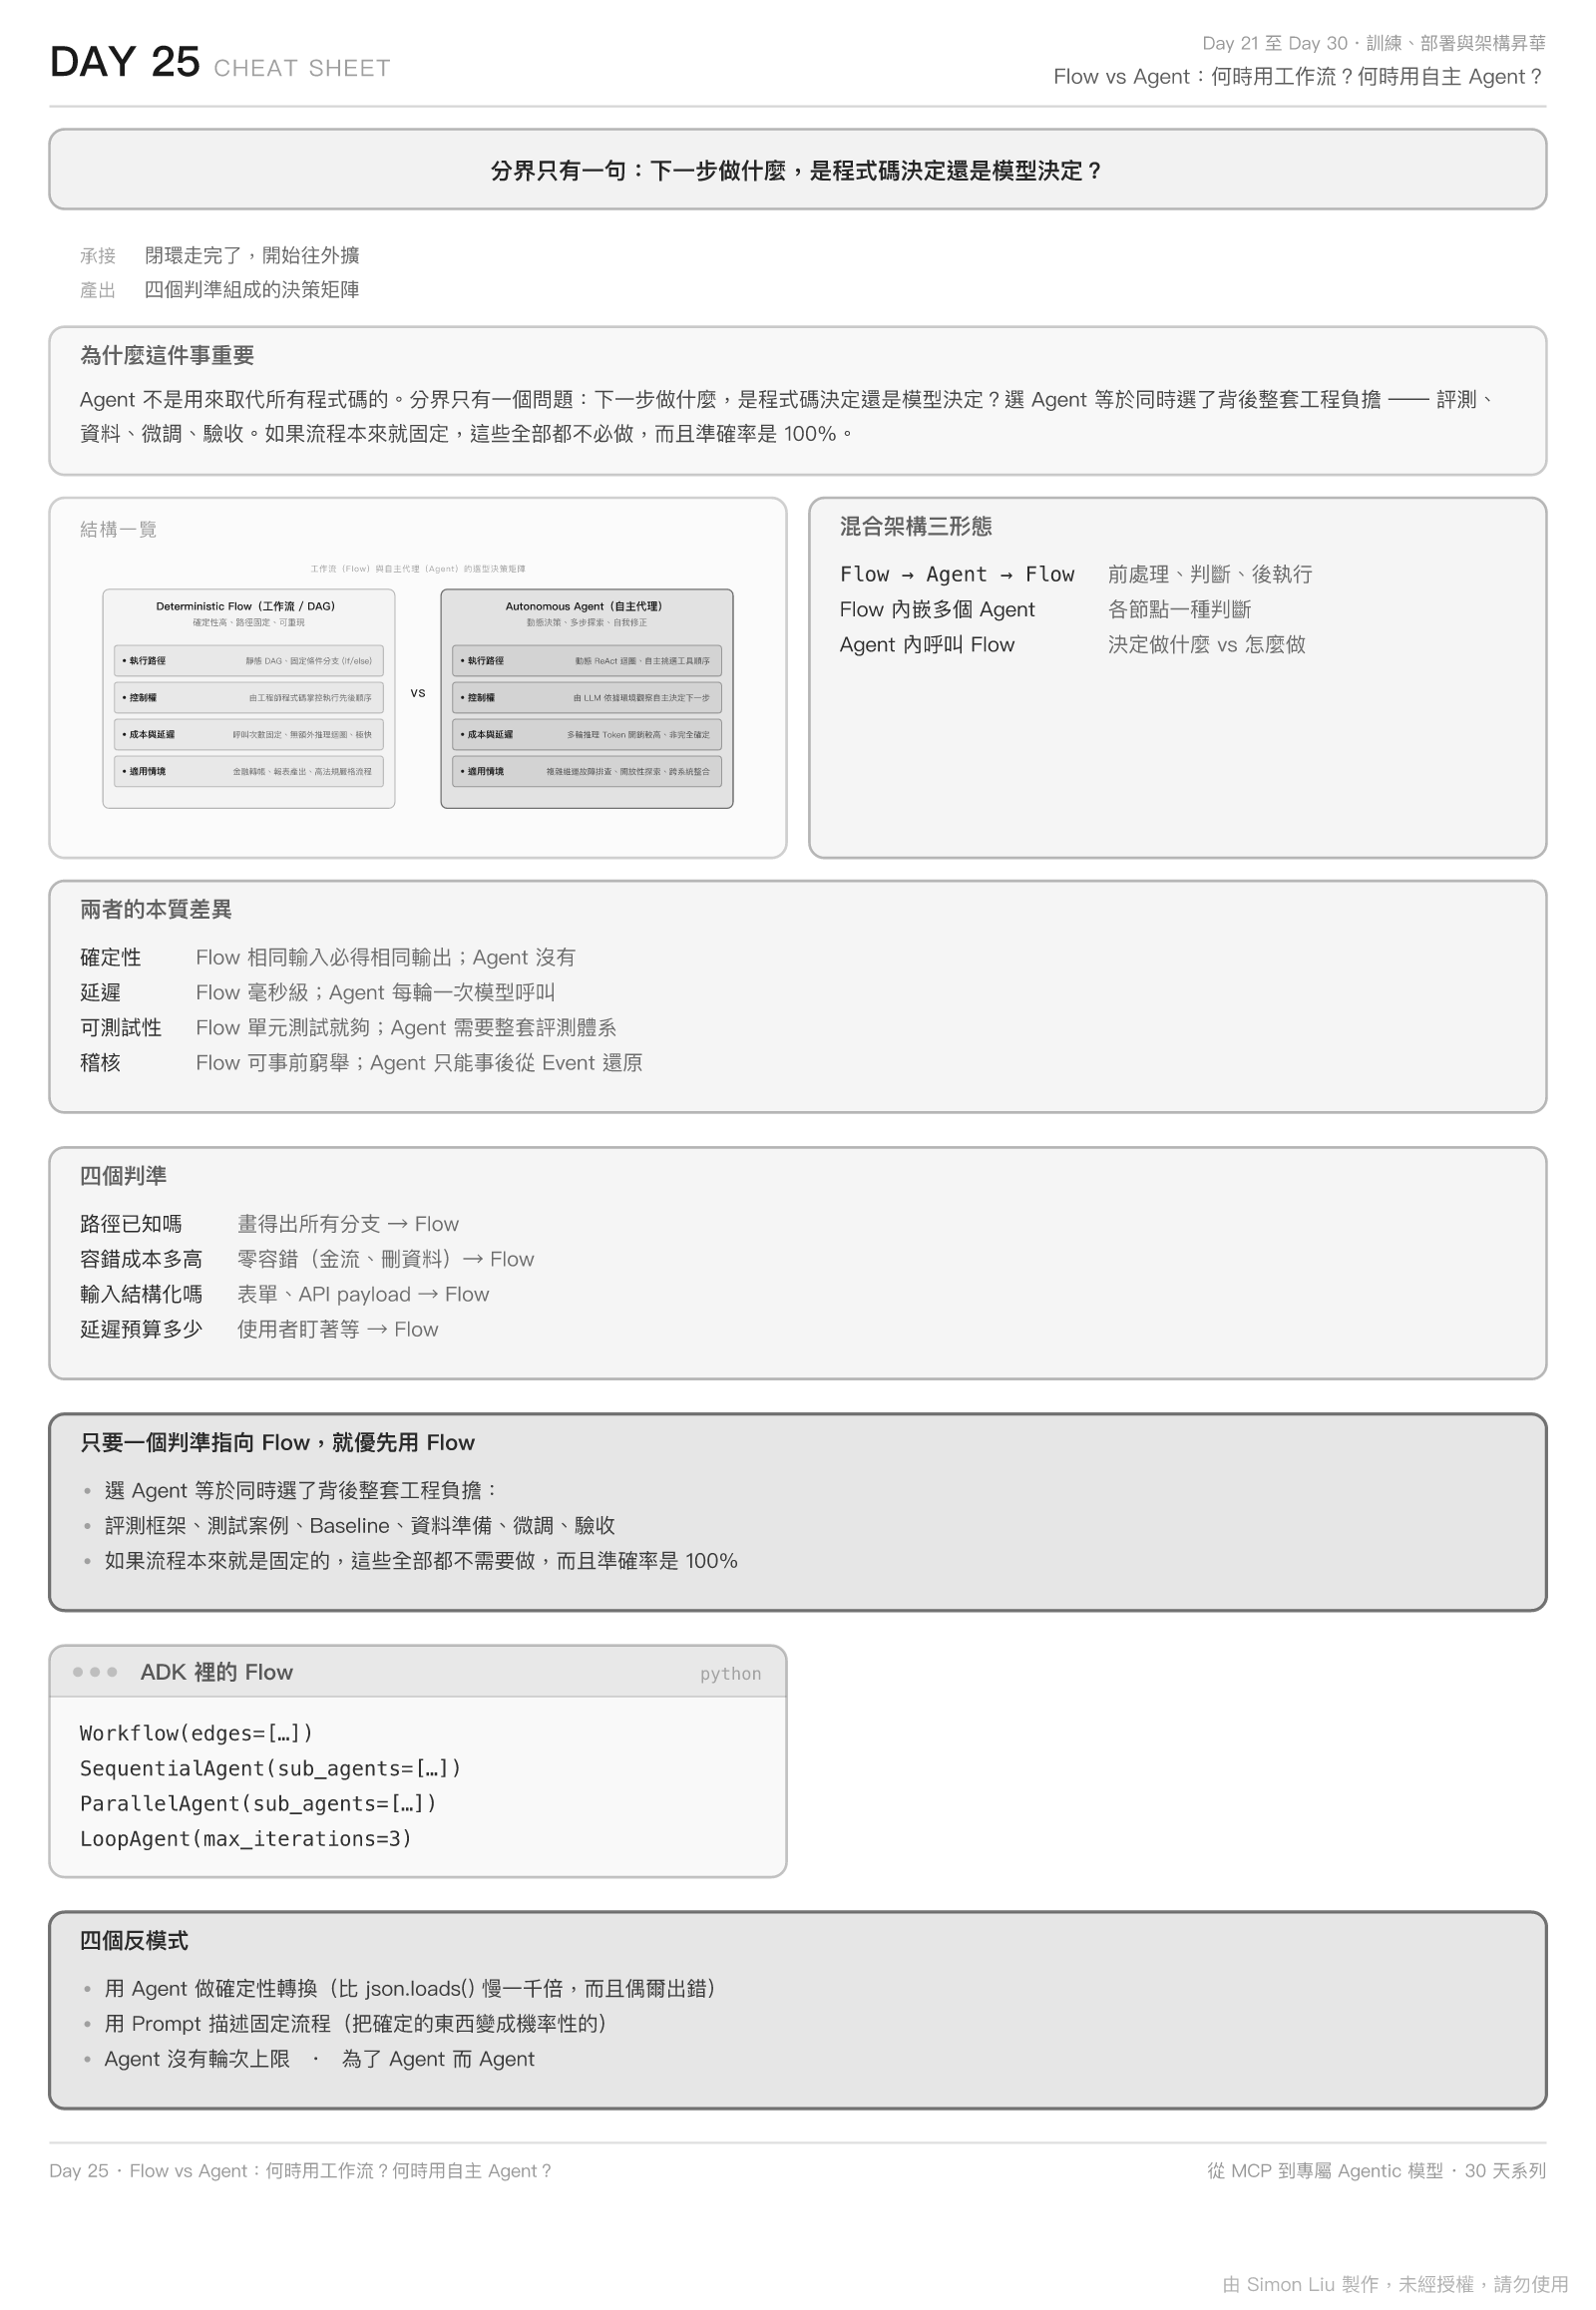
兩者的差別經常被描述成「固定 vs 彈性」,但那不夠精確。真正的分界只有一個問題:下一步做什麼,是由程式碼決定,還是由模型決定?
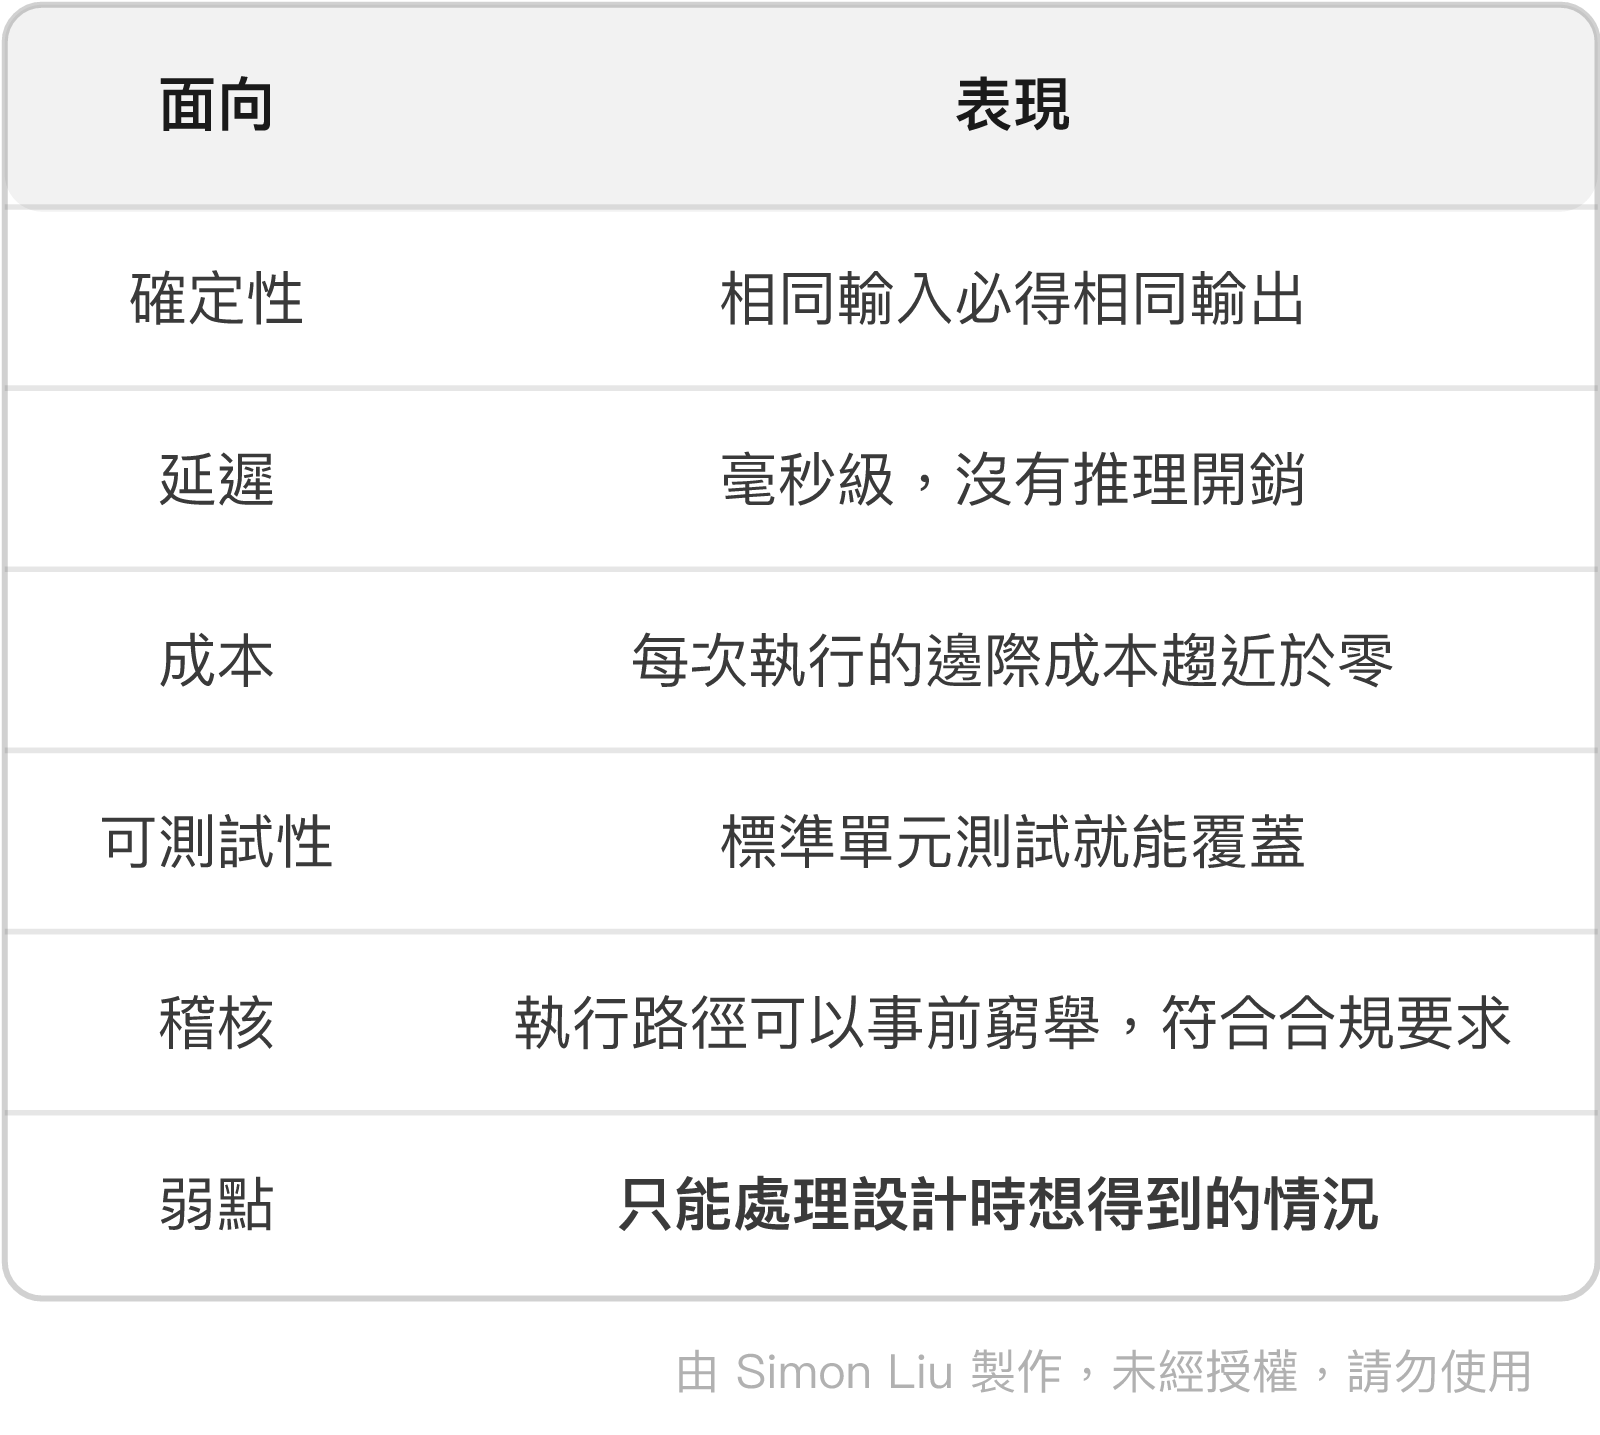
執行路徑在寫程式的時候就已經定好了 —— 用 if / else、狀態機、或是一張 DAG。
由 LLM 擔任控制器,根據每一步的觀察結果決定下一步。
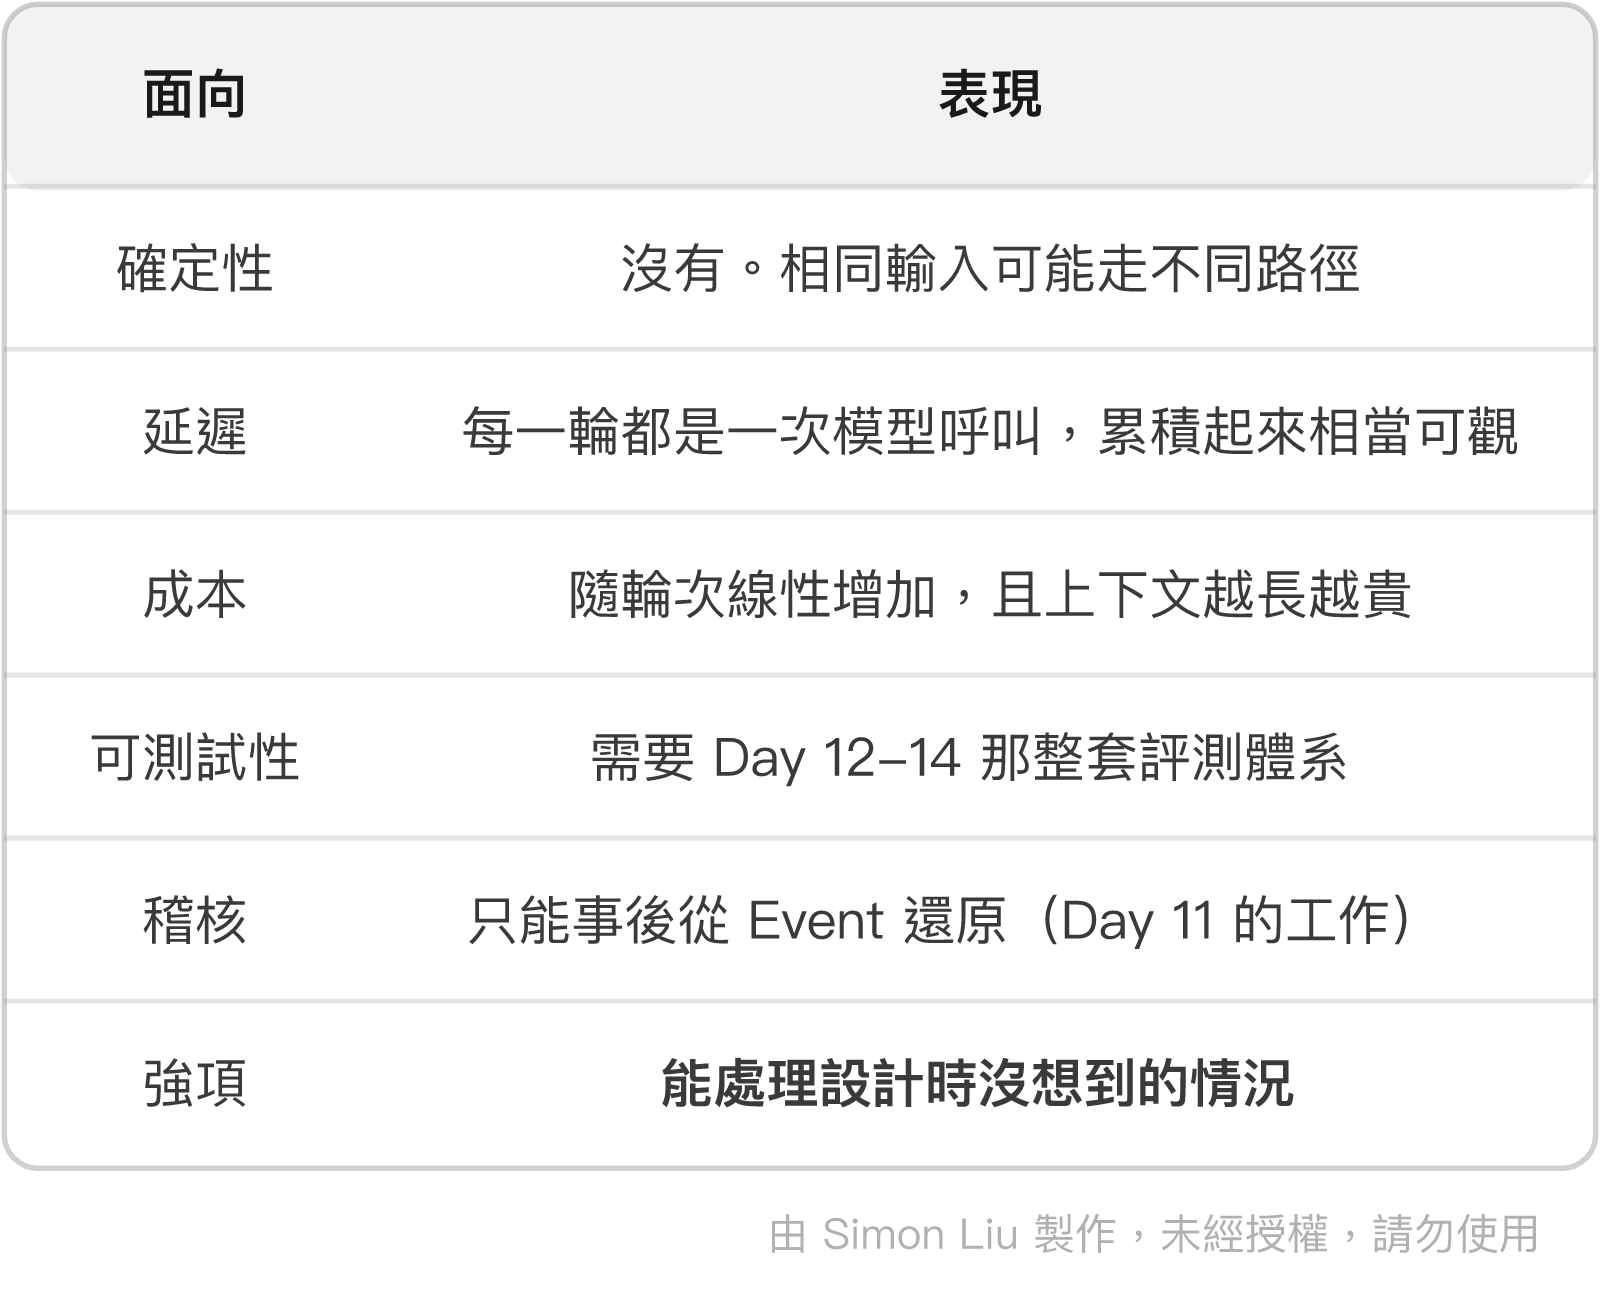
Agent 的成本不只是 Token。它還包含了讓它變得可靠所需要的全部工程投入。
回頭看這 24 天:為了讓一個 Agent 在九個工具上表現可靠,我們寫了評測框架、建了測試案例、跑了 Baseline、做了資料擴增、微調了模型、又重新驗收了一次。
如果那九個工具的呼叫順序本來就是固定的,這些工作全部都不需要做。 寫一個函式依序呼叫它們就好,而且準確率是 100%。
選 Agent,等於同時選擇了背後這一整套工程負擔。這個決定值得認真做。
實務上可以用四個問題判斷,而且只要有一個答案指向 Flow,就應該優先考慮 Flow。
判斷方式很直接:您能不能把所有分支畫成一張圖? 畫得出來就是 Flow。
這一條解釋了本系列 Day 3 的一個設計:破壞性操作走 Elicitation。 那本質上就是在 Agent 的自由度中間,硬插入一個確定性的關卡。
LLM 最不可替代的能力,是把模糊的自然語言轉成結構化的意圖。 如果輸入本來就結構化了,那就沒有用到它最擅長的部分。
這一條最常被忽略,但它在使用者體驗上的影響最直接。
把四個判準攤開:
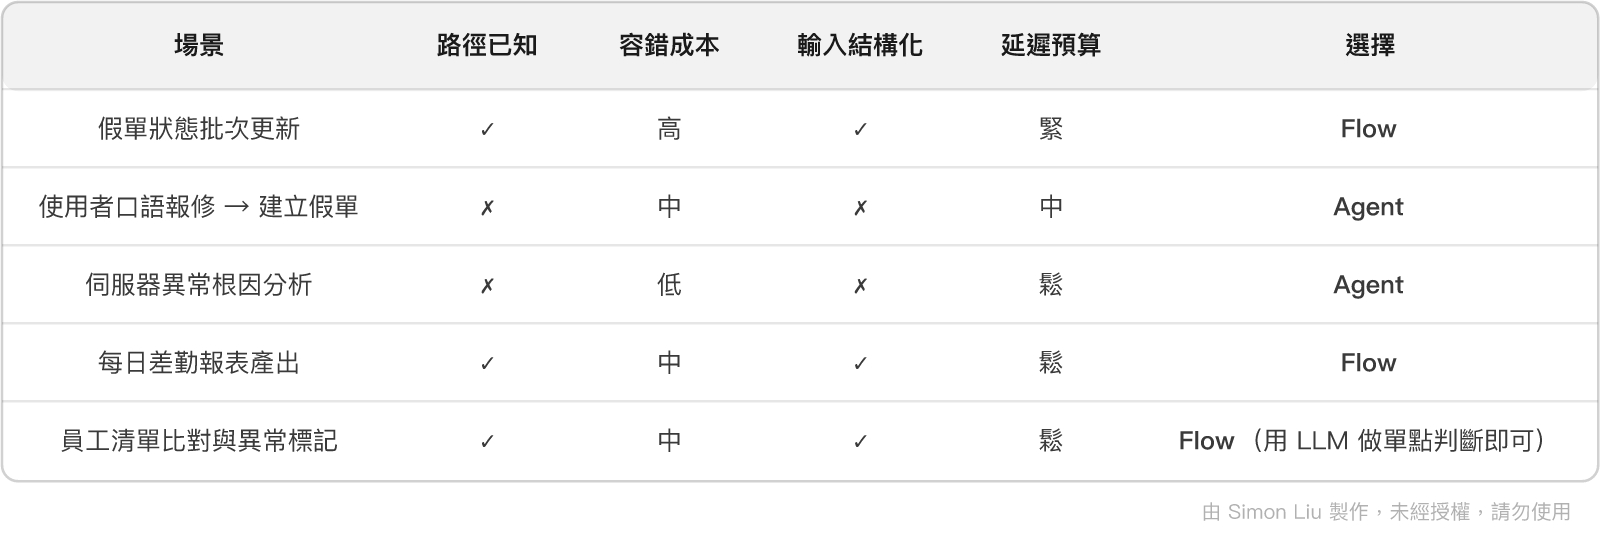
注意最後一列。 「需要用到 LLM」與「需要一個 Agent」是兩回事 —— 在 Flow 的某個節點呼叫一次模型做分類或摘要,完全不需要 Agent Loop。
成熟的企業落地,多數不是二選一,而是:外層是穩固的 Flow,只在真正需要判斷的節點嵌入 Agent。
以請假申請為例:
[Flow]  員工送出請假申請,系統自動帶出餘額與班表資料
   ↓
[Agent] Leave Copilot 判斷假別、檢查餘額與班表衝突、產出簽核建議
   ↓
[Flow]  把建議呈給主管,等待簽核
   ↓
[Flow]  簽核後由固定腳本更新假單狀態、發出通知,並記錄稽核軌跡
Agent 只出現在第二步 —— 那是唯一需要「理解」與「判斷」的地方。 前後都是確定性的流程,而最關鍵的「更新假單狀態」那一步完全不經過模型。
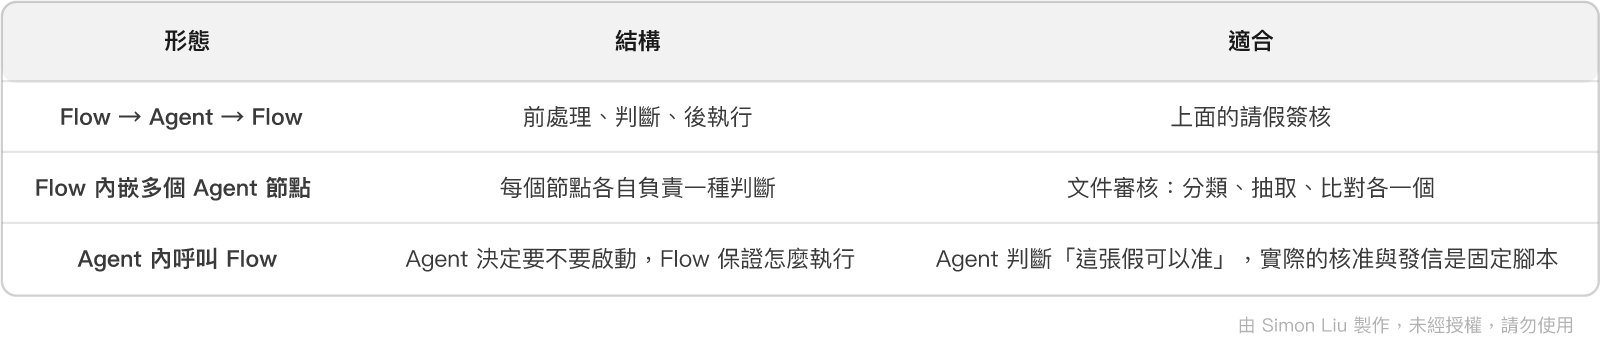
第三種特別值得注意,它把「決定做什麼」與「怎麼做」分開了 —— 模型只負責前者,後者是可稽核的程式碼。
Google ADK 2.0 對這件事有直接的支援。Workflow 用圖描述確定性流程,節點可以是函式,也可以是 Agent:
from google.adk import Agent, Workflow

# 需要判斷的節點:用 Agent
diagnose_agent = Agent(
    name="diagnose_agent",
    instruction="判斷假別、檢查餘額與班表衝突,提出簽核建議。",
    tools=[...],
)

root_agent = Workflow(
    name="leave_approval_pipeline",
    edges=[
        ("START", load_leave_context, diagnose_agent),
        (diagnose_agent, request_approval),
        (request_approval, apply_decision),
    ],
)
除了 Workflow,還有三個結構化的組合 agent,Day 10 已經用過:
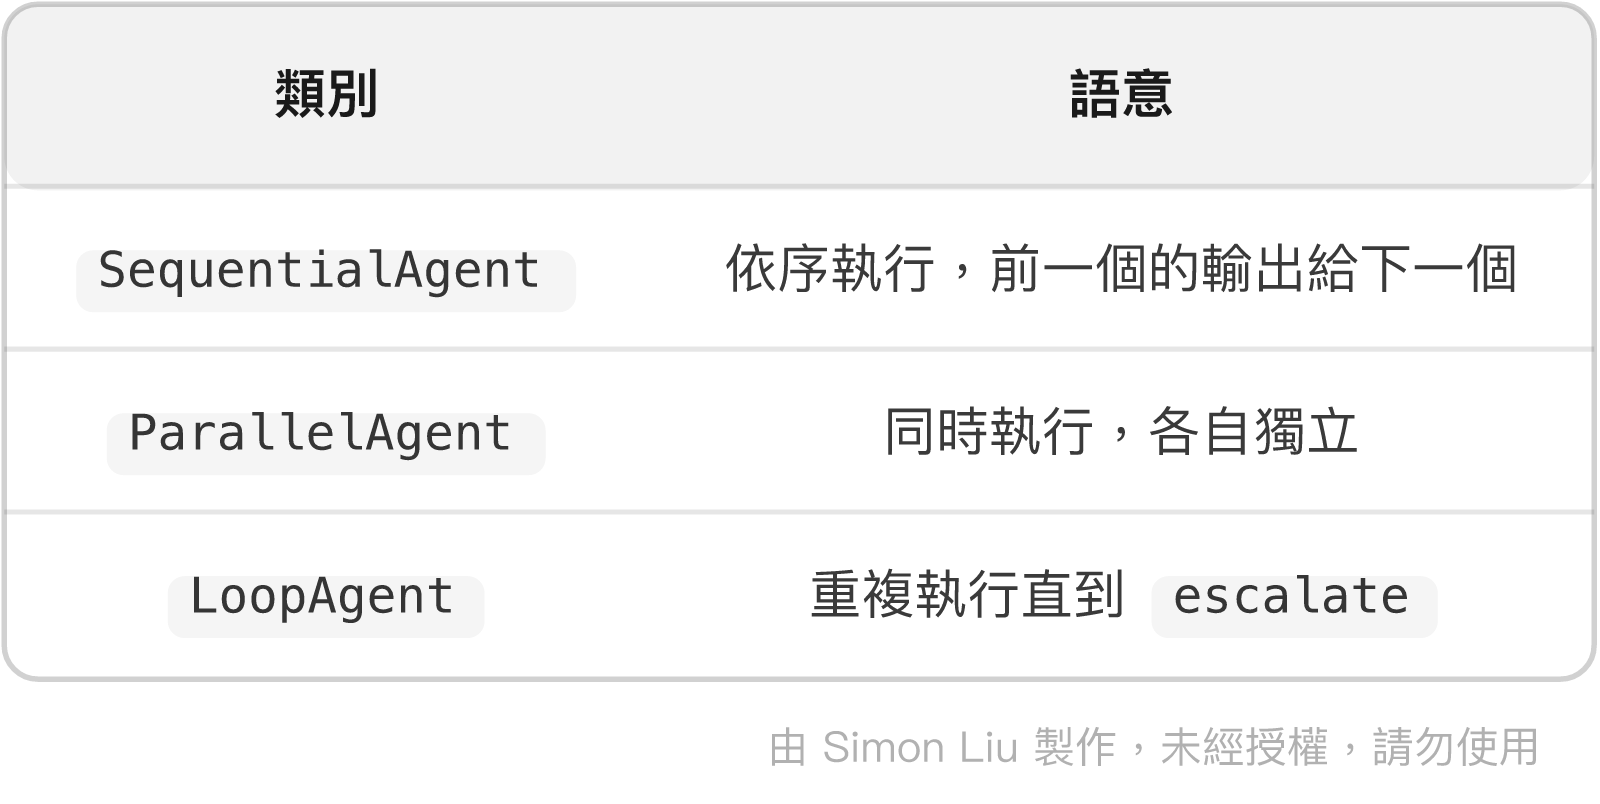
這三個的共同特徵是:流程由您決定,不是模型決定。 它們就是 Flow 在 Google ADK 裡的形態。
Day 10 選擇「先分類再處理用
SequentialAgent、要不要轉交用 sub-agent 委派」,走的正是這個原則:流程交給程式碼,判斷交給模型。
「把這個 JSON 轉成那個格式」交給 Agent,會得到一個比 json.loads() 慢一千倍、貴無限倍、而且偶爾會出錯的轉換器。
在 instruction 裡寫「第一步做 A,第二步做 B,第三步做 C」,然後期待模型照做。
如果流程已經確定到能寫成三個步驟,那就寫成程式碼。 寫在 Prompt 裡只是把確定的東西變成機率性的。
這也呼應 Day 2 的結論:規則寫在 Prompt 裡,遵從率永遠是機率問題。
沒設上限的 Agent Loop,遇到某些輸入會一直轉下去。Day 9 談自我修正時設了重試上限,就是為了這個。
任何 Agent Loop 都應該有一個明確的最大輪次,並且在達到時優雅退出。
最常見、也最貴的一種。判斷方式很簡單:如果拿掉 LLM,這個功能用傳統程式碼寫得出來嗎? 寫得出來,那就寫傳統程式碼。
Agent 不是用來取代所有程式碼的。它解決的是過去程式碼寫不出來的那一塊 —— 模糊的自然語言輸入,以及需要臨場判斷的探索空間。
總結來說,今天有三個重點值得帶走:
明天要看的是,當您確定需要 Agent 之後,Agent 內部還能怎麼組織 —— 現代 Agent 的四大設計模式:Router、Orchestrator-Workers、Evaluator-Optimizer 與 Parallelization。
Workflow 的圖式編排、edges 定義google/adk/workflow/__init__.py(google-adk 2.7.1)——Workflow、Node、Edge、JoinNode、RetryConfig
google/adk/agents/__init__.py——SequentialAgent / ParallelAgent / LoopAgent
查證日期:2026-08-24
大家好,我是 Simon 劉育維,是一位 AI 領域解決方案專家,目前也擔任 Google Cloud AI 領域開發者專家 (GDE),期待能夠幫助企業導入人工智慧相關技術解決問題。如果這篇文章對您有幫助,歡迎在我的 Linkedin 上留言提供意見,並與我一起討論有關人工智慧的主題,期待能夠對大家有所幫助!
我的個人部落格資訊:https://medium.com/@simon3458


 iThome鐵人賽
 看影片追技術